1回の電力は33分の1でも増え続けるAIの消費電力、省電力アルゴリズムの最前線
2026.11.19
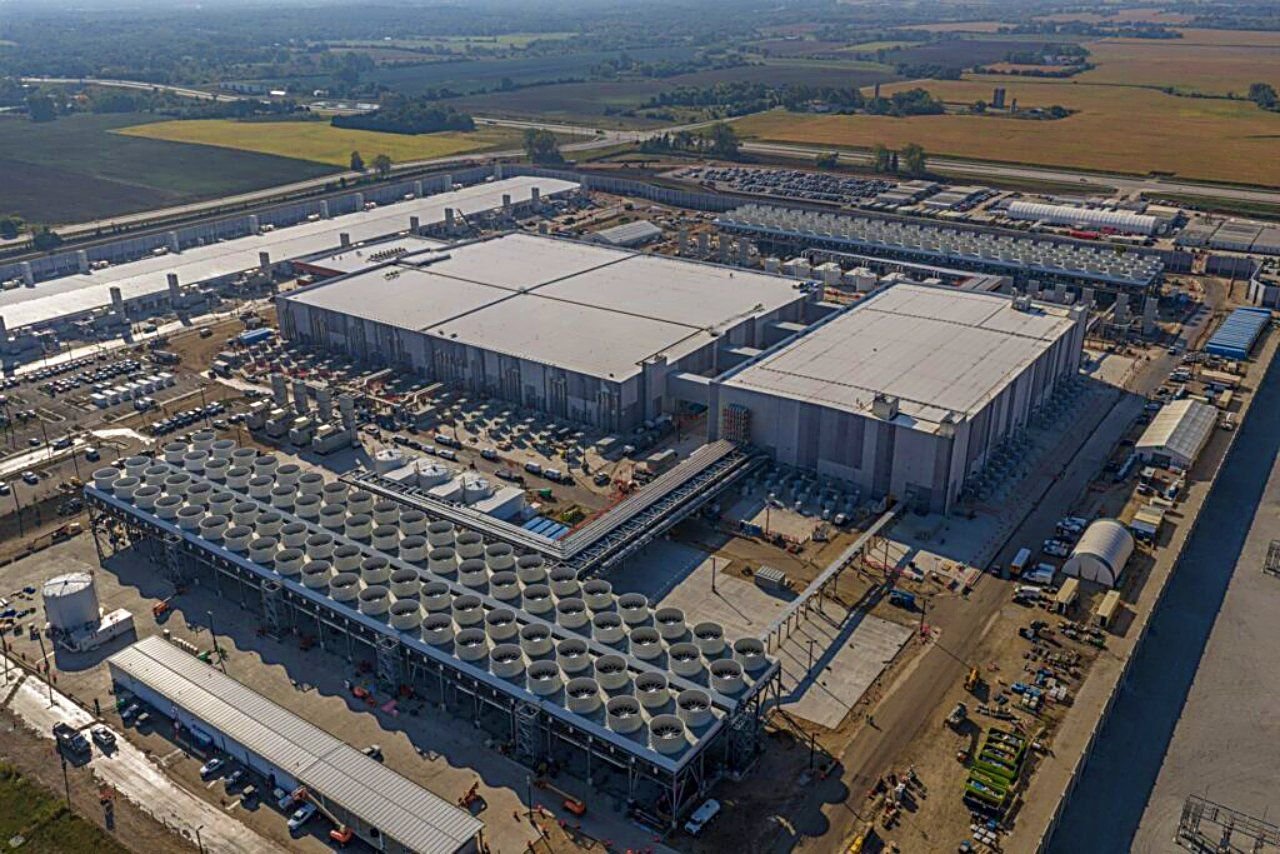
文章の要約や資料づくり、画像の生成まで、AIは仕事の道具としてすっかり身近になりました。その一方で、AIを動かすデータセンターの消費電力が急増し、「電力が足りなくなるのでは」という懸念が世界中で語られています。IEA(国際エネルギー機関)によると、世界のデータセンターの電力消費量は2024年時点で約415TWh、世界全体の電力消費の約1.5%に達しています。
では、AIの省電力化は進んでいないのでしょうか。結論から言うと、1回あたりの省エネ技術は急速に進んでいるものの、利用の拡大がそれを上回っているというのが現状です。この記事では、ハードウェア、アルゴリズム、ビジネス運用の3つの面から、AI省電力の「いま」を整理します。
AIの省電力化はどこまで進んでいるのか?
1回あたりの電力は1年で33分の1に
効率化の成果を示す数字として、Googleが2025年8月に公表したデータがあります。同社のAI「Gemini」のアプリで、テキストの質問1回に使われる電力は中央値で約0.24Wh。テレビを約9秒見るのと同じくらいです。さらに2024年5月からの12か月間で、1回あたりのエネルギーは33分の1、炭素排出は44分の1に減ったとしています。ソフトウェアの効率化とクリーン電力の調達によるもので、第三者の検証は受けていないと同社自身が断っていますが、1回あたりのコストが大きく下がっていることは確かです。
半導体とインフラの進化
ハード面では、AI専用チップの高性能化・高密度化が進んでいます。ただし性能が上がるほど発熱も増え、チップを冷やすための電力が新たな課題になりました。そこで広がっているのが、空気ではなく液体でチップを冷やす「液冷」です。日立製作所は2026年10月、数千本の微細な「U字トンネル流路」を持つ新型の冷却部品を発表し、冷却に必要な電力を従来比で約30%減らせる見込みだとしています。
さらに先を見据えた取り組みが、NTTの「IOWN(アイオン)」構想です。光回路と電気回路を一体化する「光電融合」技術を軸に、2030年ごろに電力効率を100倍にすることを目標に掲げています。ネットワークだけでなく、サーバーなどを含めた光技術の適用部分全体での目標値です。
モデルの小型化
AIそのものを小さくする動きもあります。少ないパラメータ(AIの知識や判断を担う数値)で動く「SLM(小規模言語モデル)」です。NTTが2025年10月に提供を始めた国産LLM「tsuzumi 2」は、パラメータ数を300億に抑え、GPU1基で動かせるように設計されています。必要な計算資源が少なければ、そのぶん電力もコストも抑えられます。
それでも総消費電力が増える理由
ここまで効率化が進んでも総量が増えるのは、「ジェヴォンズの逆説」と呼ばれる現象が起きているためです。19世紀の経済学者ジェヴォンズは、石炭を効率よく使える蒸気機関が普及した結果、かえって石炭の消費量が増えたことを指摘しました。AIでも、1回あたりが安くなるほど使う人と使う場面が広がります。
処理の中身が重くなっていることも理由の一つです。MIT Technology Reviewの2025年の試算では、5秒の動画を生成するのに約340万ジュールが必要で、高品質な画像1枚の700倍以上になります(この数値は過大だという指摘もあります)。また、AIが自律的に複数の作業をこなす「AIエージェント」は、1つの依頼の中で何度もAIを呼び出します。IEAは、世界のデータセンターの電力消費が2030年に約945TWhと2倍以上になり、AI向けに最適化されたデータセンターに限れば4倍以上に増えると予測しています。
力技からスマートへ!進化する「省電力アルゴリズム」
現在のAIの多くは「Transformer」という仕組みで動いています。高性能な反面、文章が長くなるほど計算量が2乗のペースで膨らむ、いわば「力技」の構造です。この計算のやり方そのものを見直すアルゴリズムが、次々と登場しています。
1ビットLLM(BitNetなど)
Microsoftの研究者らが2024年2月に発表した「BitNet b1.58」は、モデル内部の数値を「-1、0、1」の3つだけに単純化した1ビットLLMです。これによって計算の大半を、手間のかかる掛け算ではなく足し算と引き算で済ませられます。論文の試算では、行列計算にかかるエネルギーは従来の16ビットのモデルの71.4分の1。実測ではなく推定値ですが、「計算を単純にして電力を減らす」という方向性をはっきり示した研究です。
MoE(専門家混合モデル)
MoEは、モデルの中に得意分野の異なる「専門家」役の小さなネットワークを多数用意し、質問ごとに必要な専門家だけを呼び出す仕組みです。たとえば中国のDeepSeek-V3は、全体で6,710億のパラメータを持ちながら、1トークン(文字の単位)の処理で動かすのは370億だけです。全員を毎回集めるのではなく、担当者だけで会議をするイメージです。
Mamba(状態空間モデル)とSNN(脳型アルゴリズム)
2023年に発表された「Mamba」は、文章が長くなっても計算量が長さに比例してしか増えない構造を持ち、文章を生成するときは1文字ごとの処理時間が一定です。論文では、同じ規模のTransformerの約5倍の速さで文章を生成できると報告されています。
SNN(スパイキングニューラルネットワーク)は、脳の神経細胞のように、刺激(信号)があったときだけ計算する方式です。Intelは2024年4月、この方式のチップを1,152個並べた研究用システム「Hala Point」を発表しました。約11.5億個のニューロンを持ちながら、最大消費電力は2,600Wに抑えられています。
こうした研究の目標として意識されているのが、約20Wで高度な思考をこなす人間の脳です。AI開発の流れは「パラメータを増やして巨大化する」ことから、「同じ性能をより少ない計算で出す」効率化へと移りつつあります。
「無料枠を制限すれば電気代は減る?」の疑問に答える
ここで、「無料で使っている人を制限すれば電力は減るのでは」と考える方もいるかもしれません。しかし、劇的な効果は期待しにくいのが実情です。理由は2つあります。
1つ目は、電力を多く使っているのが一般のチャットではないことです。消費の大きな部分を占めるのは、大量のGPUを長期間動かすAIの「事前学習」や、企業のシステムに組み込まれて大量に呼び出されるAPI利用、そして動画生成のような重い処理です。前述のとおり、テキストのチャット1回は約0.24Wh程度にすぎません。
2つ目は、ビジネス上の理由です。AI企業にとって無料ユーザーは、利用データを通じてサービスの改善に役立つ存在であり、将来の有料顧客でもあります。電力のために無料枠をなくすことは、戦略上なかなか選べません。
そこで主流になっているのが「ルーティング」です。OpenAIが2025年8月に公開したGPT-5では、ChatGPTの中で高速な軽量モデルと、じっくり考える推論モデルを組み合わせ、「リアルタイムルーター」が質問の難しさや会話の流れに応じてどちらを使うか自動で選びます。簡単な質問は軽いモデルで済ませ、難しい質問だけを重いモデルに回すことで、利用者を制限せずに全体の計算量を抑えられます。
まとめ
AIの省電力化は、チップや冷却、光技術といったハードウェア、1ビットLLMやMoEなどのアルゴリズム、そしてルーティングのような運用の工夫という3つの面で着実に進んでいます。それでも総消費電力が増えているのは、効率化のスピード以上にAIの使われ方が広がり、高度になっているためです。
私たち利用者にもできることがあります。簡単な調べものには軽いモデルを使い、本当に必要な場面で高性能なモデルや動画生成を使う。目的に合わせてAIを使い分けることは、仕事の効率を上げるだけでなく、AI全体の省エネにも小さく貢献します。技術の進歩とあわせて、賢い使い方も身につけていきたいところです。
